Ce qu’il faut retenir : l’architecture hexagonale protège le trésor de l’application — sa logique métier — en la coupant du monde extérieur. Grâce aux ports et adaptateurs, le code ne dépend plus de l’infrastructure. Résultat ? On teste tout à la vitesse de l’éclair et on fait évoluer le projet sans sueurs froides. Une vraie forteresse imprenable pour le code.
Est-ce qu’on a vraiment envie de voir toute notre application s’effondrer comme un château de cartes juste parce qu’on a modifié un petit détail dans la base de données ? C’est pour éviter ce genre de scénario catastrophe que l’architecture hexagonale existe, en agissant comme un véritable bouclier pour structurer vos développements sans prise de tête. On vous montre ici comment cette approche permet d’isoler votre logique métier dans une bulle hermétique, rendant votre code totalement indépendant des choix techniques et surtout, incroyablement simple à tester.
L’architecture hexagonale, c’est quoi ce truc ?
Plus qu’un simple nom à la mode
On appelle aussi ce pattern « Ports et Adaptateurs« . C’est un concept pondu par Alistair Cockburn en 2005, bien avant que nos frameworks actuels ne deviennent la norme dans l’industrie.
Oubliez la géométrie sacrée. L’hexagone, c’est juste une métaphore visuelle pratique pour dire qu’une application possède de multiples points d’entrée et de sortie distincts.
L’objectif ? Isoler la logique métier pour qu’elle reste pure. Tout le reste, que ce soit votre interface utilisateur, la base de données ou les services externes, ce n’est que du détail technique à gérer en périphérie.
Le problème que ça résout vraiment
Vous connaissez l’enfer des architectures en couches où tout finit par se mélanger ? On touche à la base de données et tout s’effondre, un peu comme une opération à cœur ouvert risquée.
L’architecture hexagonale rend votre code agnostique de l’infrastructure. En gros, le cœur de votre appli s’en moque royalement de la technologie qui l’entoure ou de la base de données utilisée.
C’est ça la vraie flexibilité : votre application peut être pilotée indifféremment par un humain, un script automatique ou une suite de tests, sans que le noyau ne change d’un iota.
Les grands principes en un coup d’œil
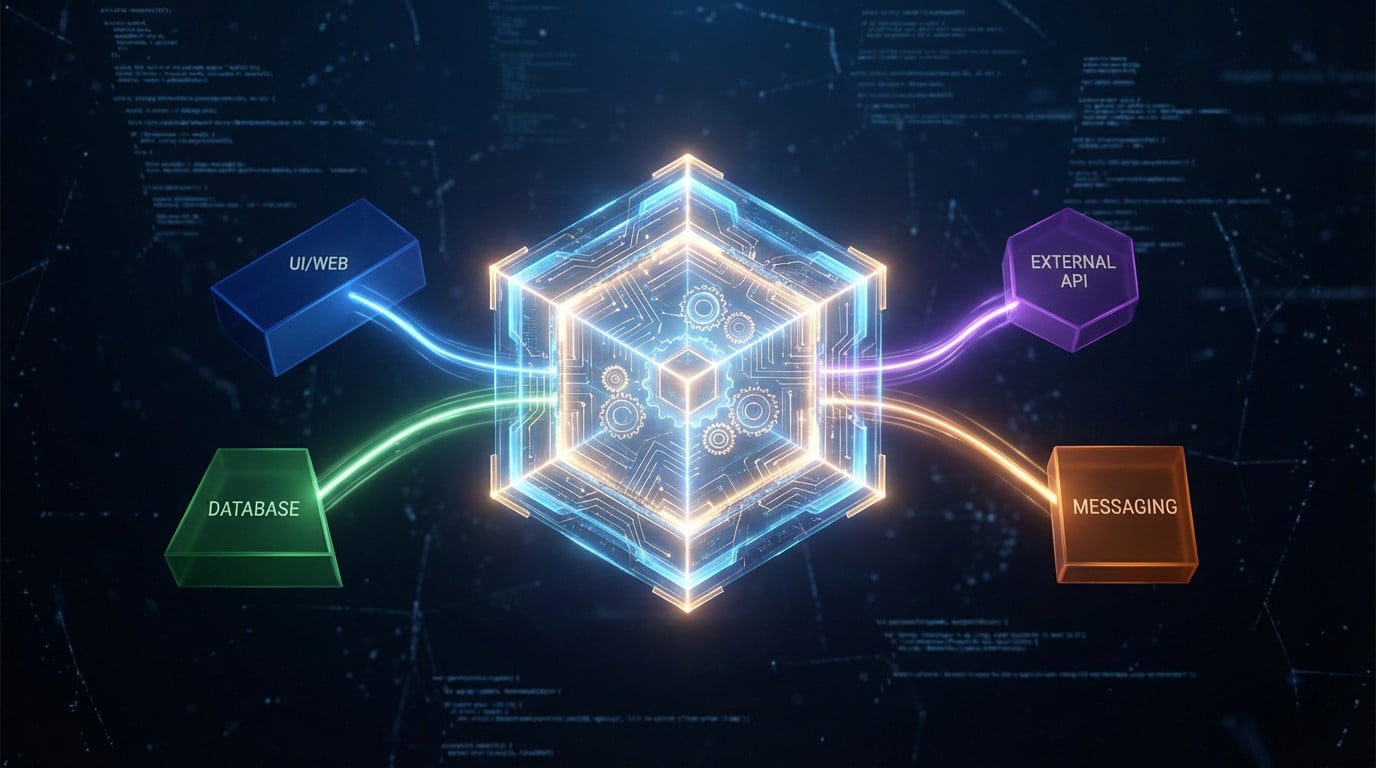
Visualisez trois zones distinctes. D’abord le côté utilisateur (User-Side), ensuite votre logique métier au centre (l’hexagone), et enfin le côté serveur (Server-Side) pour la gestion des données.
Voici la règle d’or à respecter : toutes les dépendances doivent pointer vers l’intérieur, vers le centre. Jamais l’inverse. Le métier ne doit dépendre de rien d’autre que lui-même.
Pour communiquer, on utilise des « Ports » et des « Adaptateurs ». Ce sont les gardiens de la frontière : les ports définissent les contrats nécessaires, et les adaptateurs font le sale boulot d’implémentation pour connecter le monde extérieur.
- La séparation claire des responsabilités (logique métier vs. infrastructure).
- La règle d’inversion des dépendances vers le centre.
- L’utilisation de ports et d’adaptateurs pour la communication.
Le cœur du réacteur : protéger votre logique métier
Qu’est-ce que la « logique métier » au juste ?
La logique métier, c’est tout sauf du vent. Concrètement, ce sont les règles, les calculs et les processus qui donnent sa valeur à votre application et la rendent unique face à la concurrence. Prenons un exemple parlant sur un site e-commerce : c’est le calcul précis des frais de port, la validation d’un code promo ou la gestion intelligente des stocks. C’est pas juste du code, c’est le véritable trésor de votre entreprise, son savoir-faire brut.
La forteresse : pourquoi l’isolement est non négociable
Mélanger cette logique avec du code technique (accès BDD, interface), c’est jouer avec le feu. Vous créez une structure fragile où la moindre mise à jour technique risque de tout casser, et ça, personne ne le veut. Séparer les deux, c’est la clé pour garantir la robustesse et la maintenabilité. En plaçant la technologie au cœur de l’architecture via des adaptateurs, on peut faire évoluer l’infrastructure sans jamais égratigner le métier.
Le domaine, ce monde pur sans dépendances
Dans l’architecture hexagonale, le domaine vit dans sa propre bulle. Il ignore tout du monde extérieur : il ne sait pas ce qu’est une base de données, un framework web ou une API REST. Il ne manipule que ses propres concepts et objets, comme un Utilisateur ou une Commande, restant ainsi totalement autonome. C’est cette pureté absolue qui le rend extrêmement simple à tester de manière unitaire, fiable et rapide.
Ports et adaptateurs : les gardiens de la frontière
Les ports : les prises électriques de votre application
On entend souvent parler de ports en architecture hexagonale, mais c’est quoi au juste ? Imaginez une simple interface codée directement dans le métier. C’est un contrat strict qui dit : « voilà ce dont j’ai besoin pour bosser » ou « voilà ce que je vous offre ». Pas de blabla technique ici, on reste sur du fonctionnel pur.
Concrètement, votre logique métier déclare : « J’ai besoin d’un moyen de sauvegarder un utilisateur, voici le contrat à respecter » (le port). Elle se fiche totalement de savoir si c’est dans une base SQL ou un fichier texte. C’est ça, la vraie indépendance.
Il faut juste faire la distinction fondamentale entre les ports entrants (l’API qui pilote l’application) et les ports sortants (les services dont l’application a besoin). Si vous ratez ça, vous risquez de transformer votre code en un plat de spaghettis indigeste (Loss Aversion).
Les adaptateurs : les fiches qui se branchent sur les ports
Si le port est la prise murale, l’adaptateur est la fiche électrique. C’est l’implémentation concrète d’un port, le vrai code de « plomberie » qui se salit les mains avec une technologie spécifique. C’est lui qui fait le sale boulot pour que le métier reste propre.
Prenons l’exemple d’un port sortant « SauvegarderUtilisateur ». Un adaptateur pourrait être « SauvegarderUtilisateurDansPostgreSQL », un autre « SauvegarderUtilisateurDansFichier ». Vous changez d’avis sur la base de données ? On change juste l’adaptateur, sans toucher une ligne du métier.
Côté entrant, c’est la même logique. Un contrôleur d’API REST est en fait un adaptateur : il reçoit une requête HTTP (le bruit du web) et la traduit en un appel de méthode clair sur la logique métier.
L’art de brancher les bons fils
Mais comment tout ça tient ensemble ? Ce « branchement » vital se fait uniquement au démarrage de l’application, dans une couche de composition externe. C’est le moment de vérité où les pièces du puzzle s’assemblent, loin du regard du domaine.
Voici le processus : la couche d’infrastructure crée les adaptateurs concrets (par exemple, le repository pour la base de données) et vient les « injecter » délicatement dans la logique métier. Le cœur reçoit exactement ce qu’il a demandé, sans savoir d’où ça vient.
C’est toute la magie de l’injection de dépendances qui permet de tout connecter sans créer de couplage fort. Sans cette rigueur, maintenir votre application deviendra vite un enfer coûteux.
La règle d’or : les dépendances vont toujours vers l’intérieur
Comprendre le flux des dépendances
On va être clair : ce qui se passe dans l’hexagone reste strictement dans l’hexagone. Aucun bout de code situé à l’intérieur ne doit connaître, ni même soupçonner, ce qui existe dehors.
Concrètement, votre interface utilisateur dépend de la logique métier, jamais l’inverse. C’est exactement la même punition pour l’adaptateur de base de données.
La logique métier, elle, ne dépend de personne. Elle trône au centre, indifférente à la techno qui l’entoure ou à la base de données utilisée. C’est le point stable, le véritable cœur battant de votre application.
L’inversion de dépendance (le « D » de SOLID) en action
Imaginez un chef de chantier exigeant qui ne va pas chercher ses outils. Au lieu de ça, il décrit l’outil qu’il veut, et c’est à l’ouvrier (l’infrastructure) de fournir le bon matos.
En code, ça veut dire que la logique métier n’appelle jamais une classe technique comme RepositoryPostgreSQL. Elle appelle une interface abstraite RepositoryUtilisateur (le port).
Ensuite, c’est la classe RepositoryPostgreSQL (l’adaptateur) qui se charge d’implémenter concrètement cette interface. Voilà comment on applique le fameux principe d’inversion des dépendances sans se tordre le cerveau.
Pourquoi c’est une libération pour les développeurs
Ça offre une liberté assez dingue, et pas de bullshit marketing ici. On peut changer de base de données, de service de messagerie ou d’API externe simplement en écrivant un nouvel adaptateur, sans toucher au reste.
Fini les sueurs froides des refactorings massifs et risqués à chaque mise à jour technique. Le cœur de l’application reste stable et intouché, totalement protégé du chaos extérieur.
Cette flexibilité permet de bâtir une architecture sur mesure qui évolue vraiment avec vos besoins. On ne subit plus la dette technique, on la maîtrise enfin.
Acteurs pilotants vs pilotés : qui commande qui ?
Le côté gauche : les acteurs qui pilotent l’application
On appelle souvent ce côté le « User-Side », mais soyons honnêtes, le terme « acteurs pilotants » est bien plus parlant. C’est eux qui ont le doigt sur la gâchette. Dans une architecture hexagonale bien huilée, rien ne se passe tant que l’un d’eux n’a pas décidé de bouger. C’est le point de départ de toute interaction.
Imaginez un utilisateur qui s’acharne sur un bouton « Commander », un script de test automatisé qui lance une suite de vérifications en pleine nuit, ou une API externe qui vient réveiller votre système. Ce sont les patrons. Leurs adaptateurs, comme un contrôleur web ou une CLI, vont directement appeler la logique métier via les ports entrants. Ils ordonnent, et le système s’exécute sans discuter.
Le côté droit : les services pilotés par l’application
De l’autre côté du miroir, on trouve les « acteurs pilotés », souvent relégués au terme générique de « Server-Side ». Eux, ce sont les petites mains, les ouvriers de l’ombre. Ils ne prennent jamais d’initiative ; ils attendent sagement que la logique métier daigne leur donner du travail à accomplir.
On parle ici de votre base de données pour persister les infos, d’un service tiers pour expédier des e-mails transactionnels, ou simplement du système de fichiers. La magie opère quand la logique métier les pilote via des ports sortants. Elle utilise ces interfaces sans jamais savoir ce qui se trame dans cette galère de l’intérieur.
Tableau de bord : inbound vs outbound
Pour visualiser clairement cette distinction sans devoir relire trois fois la documentation technique, rien ne vaut un bon vieux tableau comparatif. Ça permet de fixer les idées une bonne fois pour toutes.
| Caractéristique | Acteurs Pilotants (Inbound) | Acteurs Pilotés (Outbound) |
|---|---|---|
| Rôle | Pilote l’application | Est piloté par l’application |
| Alias | Côté Gauche / User-Side | Côté Droit / Server-Side |
| Exemples | Contrôleur web, Tests d’acceptation, Script CLI | Base de données, Service d’email, API externe |
| Type de Port | Port Entrant (API du domaine) | Port Sortant (SPI du domaine) |
| Flux de dépendance | L’adaptateur appelle le port (dépendance directe) | Le port est implémenté par l’adaptateur (inversion de dépendance) |
Ce tableau met en évidence la symétrie visuelle mais surtout la différence fondamentale dans la gestion des dépendances entre les deux côtés.
Les vrais bénéfices au quotidien : testabilité et maintenabilité
Des tests enfin simples et rapides
Soyons honnêtes, le gain le plus spectaculaire avec l’architecture hexagonale, c’est la testabilité. On peut enfin valider 100 % des règles métier en isolation totale. Plus besoin de lancer un serveur web lourd ou une base de données capricieuse.
C’est une libération. Les tests s’exécutent en mémoire, en quelques millisecondes seulement. On utilise des « doublures » (mocks, stubs) pour simuler les dépendances externes. Résultat ? Un feedback immédiat et sans friction.
Fini l’enfer des tests d’intégration lents et instables juste pour vérifier une petite règle de calcul. On ne perd plus son temps à attendre que l’environnement daigne répondre.
Une maintenance qui ne vire pas au cauchemar
Parlons maintenabilité. Ici, le code est rangé par fonctionnalité métier, ce qui est logique pour un humain, et non par type technique obscur. On ne cherche plus une aiguille dans une botte de foin.
Du coup, on trouve les bugs plus vite et on modifie le code plus sûrement. Le risque de tout casser par inadvertance est fortement réduit. On dort mieux la nuit, croyez-moi.
Un exemple ? Si on veut changer de base de données, on écrit juste un nouvel adaptateur. Le cœur du système ne bouge pas d’un iota. C’est propre.
Les avantages en résumé
C’est un investissement au départ, on est d’accord. Mais sur la durée, ça rapporte gros pour l’équipe.
- Testabilité maximale de la logique métier en isolation.
- Indépendance vis-à-vis de l’infrastructure (BDD, UI, frameworks).
- Évolution et maintenance simplifiées, réduisant les risques.
- Code plus clair et plus facile à comprendre pour les nouveaux arrivants.
Pour creuser d’autres sujets techniques aussi pointus, faites un tour sur notre blog.
Hexagone, clean, oignon : faut-il choisir son camp ?
Si vous avez déjà exploré le sujet, vous avez sûrement croisé d’autres noms comme « Clean Architecture » ou « Onion Architecture ». Démêlons un peu tout ça.
Des philosophies très proches
Hexagonale, Clean Architecture de Robert C. Martin, Oignon… on s’y perd vite, mais ces approches partagent en réalité la même philosophie de fond. L’objectif unique reste de protéger le domaine métier en forçant toutes les dépendances à pointer vers le centre, loin des détails techniques. Au final, les différences relèvent plus de la nuance de vocabulaire ou du découpage des couches externes que d’une réelle opposition conceptuelle.
Le lien naturel avec le domain-driven design (DDD)
L’architecture hexagonale s’impose souvent comme le partenaire technique idéal du Domain-Driven Design. C’est simple : si le DDD se focalise sur le « quoi » — une modélisation riche et précise du métier —, l’hexagone apporte le « comment » avec une structure béton pour isoler ce modèle. Cette alliance devient une évidence, voire une nécessité, dès qu’on s’attaque à des applications portant une vraie complexité métier sur les épaules.
Alors, on l’adopte ou pas ?
Attention, ce n’est pas une solution miracle à dégainer partout ; pour un simple site vitrine ou une appli CRUD basique, c’est clairement de la sur-ingénierie. Cette architecture cible spécifiquement les projets avec une logique métier riche et évolutive, où la pérennité du code est un enjeu financier réel.
En bref, l’hexagone est pour vous si :
- Votre application a des règles métier complexes.
- Vous prévoyez que votre technologie va évoluer (changement de BDD, etc.).
- La testabilité et la maintenabilité sont des priorités absolues pour votre projet.
C’est une approche robuste qui s’intègre d’ailleurs très bien dans des plateformes comme Ameranth Architect.
Bref, l’architecture hexagonale, c’est pas juste pour briller en société. C’est le secret pour dormir sur ses deux oreilles pendant que le code tourne comme une horloge (suisse, évidemment 🇨🇭). On isole le cœur, on branche les fils, et hop… fini le stress des mises à jour ! C’est un investissement, certes, mais la liberté technique, ça n’a pas de prix.
Je m’appelle Jenny, je suis architecte à Lyon et passionnée par une architecture plus écologique et innovante, celle qui respecte autant les lieux que les personnes qui y vivent. J’ai commencé à écrire après avoir vu un simple croquis devenir un projet durable concret, et réalisé à quel point le partage d’idées peut faire avancer les pratiques. Ici, j’écris pour transmettre une vision optimiste et engagée de l’architecture d’aujourd’hui.